ضغط الصور التكيّفي بالذكاء الاصطناعي
ضغط يراعي المحتوى: شبكة عصبية تقرّر أي أجزاء الصورة مهمة، فيبقى النص واضحاً بينما يُضغط الباقي بقوة.
نظرة عامة
الضغط العادي يعامل كل البكسلات بالتساوي، فتفقد لقطة الشاشة أو المستند الممسوح وضوحه في الأماكن التي يحتاج الناس لقراءتها بالضبط. يقسّم هذا المشروع الصورة إلى مربعات، ويتنبأ بأهمية كل مربع، ولا يصرف الجودة إلا حيث تهمّ.
مسار المعالجة
01التقسيمتُقسَّم الصورة المرفوعة إلى مربعات 64×64، وتُكمَّل مربعات الأطراف بأصفار.
02إيجاد النصيعمل Tesseract على نسخة ثنائية الألوان (بطريقة Otsu)، ويُرسم مربع كل كلمة مكتشفة في قناع ثنائي — قناة رابعة بجانب الألوان الثلاثة.
03التقييميمرّ كل مربع (بحجم 128×128×4) عبر المصنِّف، فيعيد احتمال أهميته.
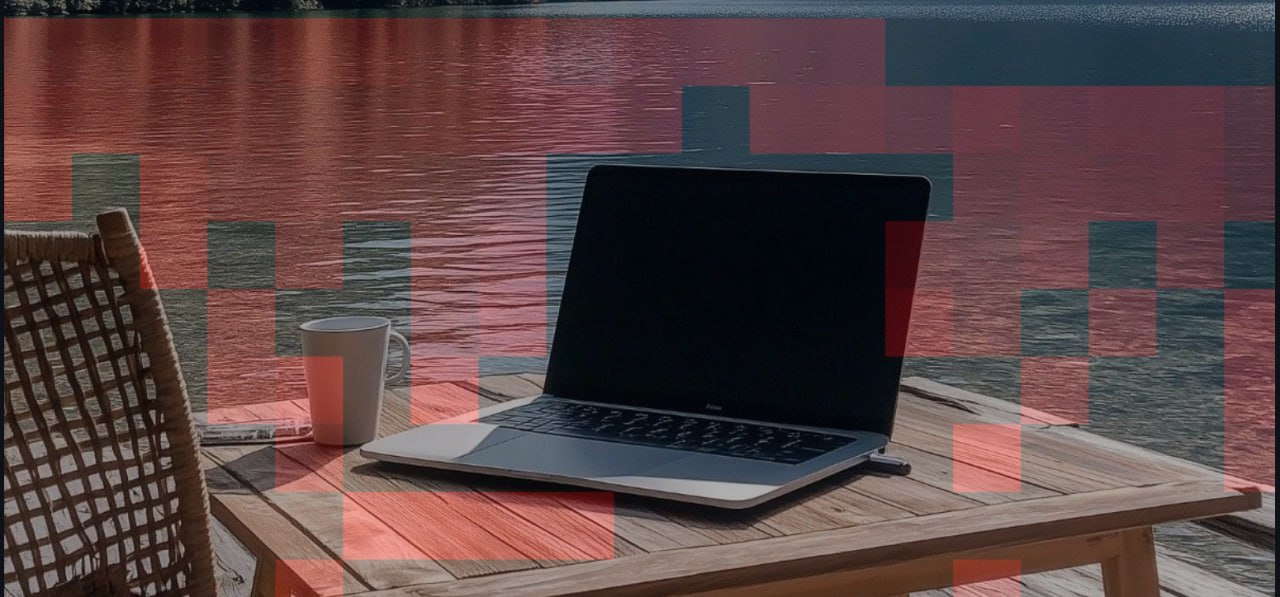
04التكييفالمربعات فوق العتبة تحتفظ بدقتها الكاملة مع استيفاء Lanczos، والباقي يُصغَّر (إلى 40% افتراضياً) ثم يُعاد تكبيره باستيفاء خطي أرخص.
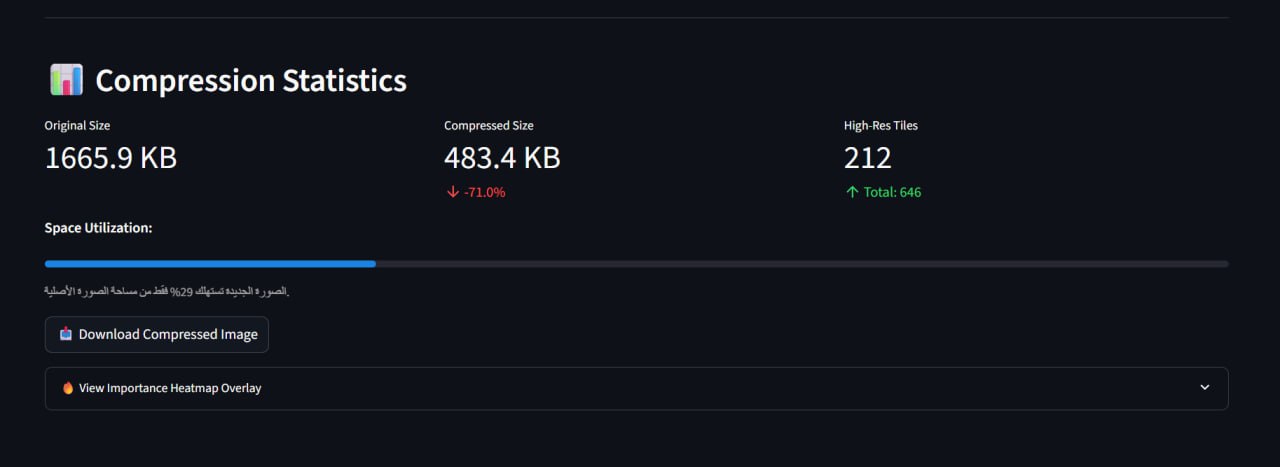
05إعادة البناء والترميزتُجمع المربعات من جديد وتُحفظ JPEG بالجودة المختارة، ويعرض التطبيق نسبة التخفيض وخريطة حرارية للأهمية.
النموذج
الفرع البصري
MobileNetV2 مدرّب مسبقاً على ImageNet، مع ضبط آخر 30 طبقة فقط، يليه تجميع متوسط شامل.
فرع النص
فرع التفافي صغير (16 مرشّحاً مع تجميع أقصى) يقرأ قناع OCR وحده.
رأس الدمج
يُدمج متجها السمات، ثم Dense(256) ← Dropout(0.4) ← Dense(64) ← sigmoid.
التدريب
Adam بمعدّل 1e-4، وخسارة binary cross-entropy، وأوزان متوازنة للفئات، وإيقاف مبكر، وتخفيض معدّل التعلّم عند الثبات.
كيف صُنِّفت بيانات التدريب
لم يكن تصنيف مجموعة صور كاملة يدوياً واقعياً، لذلك تُنتَج التصنيفات تلقائياً. يشغّل سكربت معالجة مسبقة OCR على كل صورة ويقيس نسبة مساحتها التي يغطيها النص: 1% أو أكثر تُصنَّف «مهمة»، وما دون ذلك «غير مهمة». ثم تتعلّم الشبكة تعميم هذه الإشارة من البكسلات والقناع معاً.
التطبيق التفاعلي
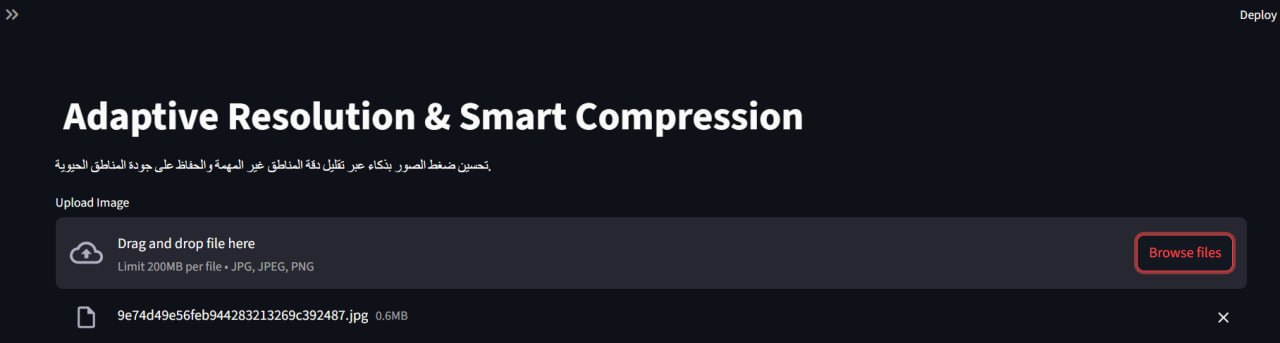
- ضبط فوري: أشرطة لعتبة الأهمية (0.6 افتراضياً)، ونسبة تصغير المربعات المهمة وغير المهمة، وجودة JPEG النهائية (85 افتراضياً).
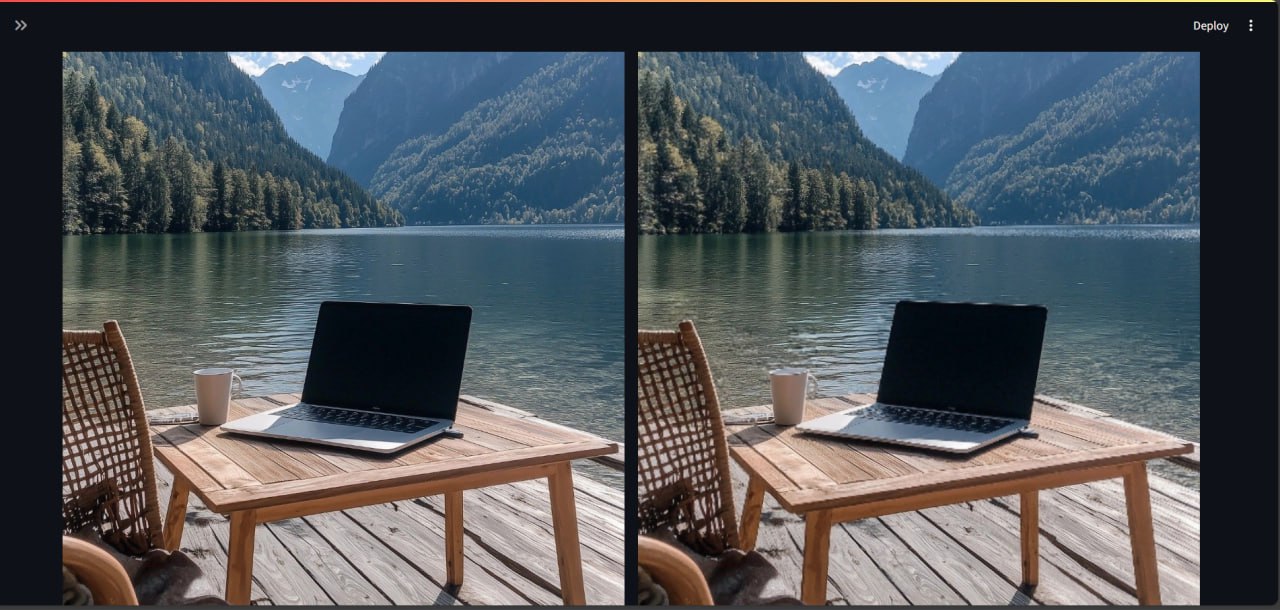
- مقارنة جنباً إلى جنب بين الصورة الأصلية والمضغوطة، مع حجمي الملفين والنسبة الموفَّرة.
- خريطة حرارية تُظهر المربعات التي اعتبرها النموذج مهمة.
- تنزيل بنقرة واحدة للنتيجة المضغوطة.
ينخفض حجم الملف حتى 60–80% مقارنة بنفس الصورة محفوظة JPEG بجودة 100، مع بقاء النص مقروءاً.
الحدود الحالية
- «مهم» يعني حالياً «يحتوي نصاً»، لأن هذا ما تعبّر عنه التصنيفات. الوجوه والأجسام الأخرى هي الهدف التالي.
- الأهمية ثنائية لكل مربع، وليست مستوى جودة متدرّجاً.
- جودة OCR تحدّ من دقة التصنيفات: قد يفوته النص الضبابي أو المزخرف.
التشغيل
git clone https://github.com/AAFLY99/ai-adaptive-image-compression.git
cd ai-adaptive-image-compression
pip install -r requirements.txt   # also install Tesseract OCR on your system
python classify.py                 # label the dataset with OCR
python train.py                    # train the tile classifier
streamlit run app.py
بيانات التدريب والنماذج المدرّبة غير مضمّنة في المستودع بسبب حجمها.